robots.txt или llms.txt — какой файл реально читают боты
Их постоянно ставят в один ряд: мол, robots.txt — старый файл для поисковиков, llms.txt — новый для нейросетей. Обновись, добавь второй.
Смотри, в чём подвох: это не старая и новая версия одного и того же. Задачи у них противоположные.
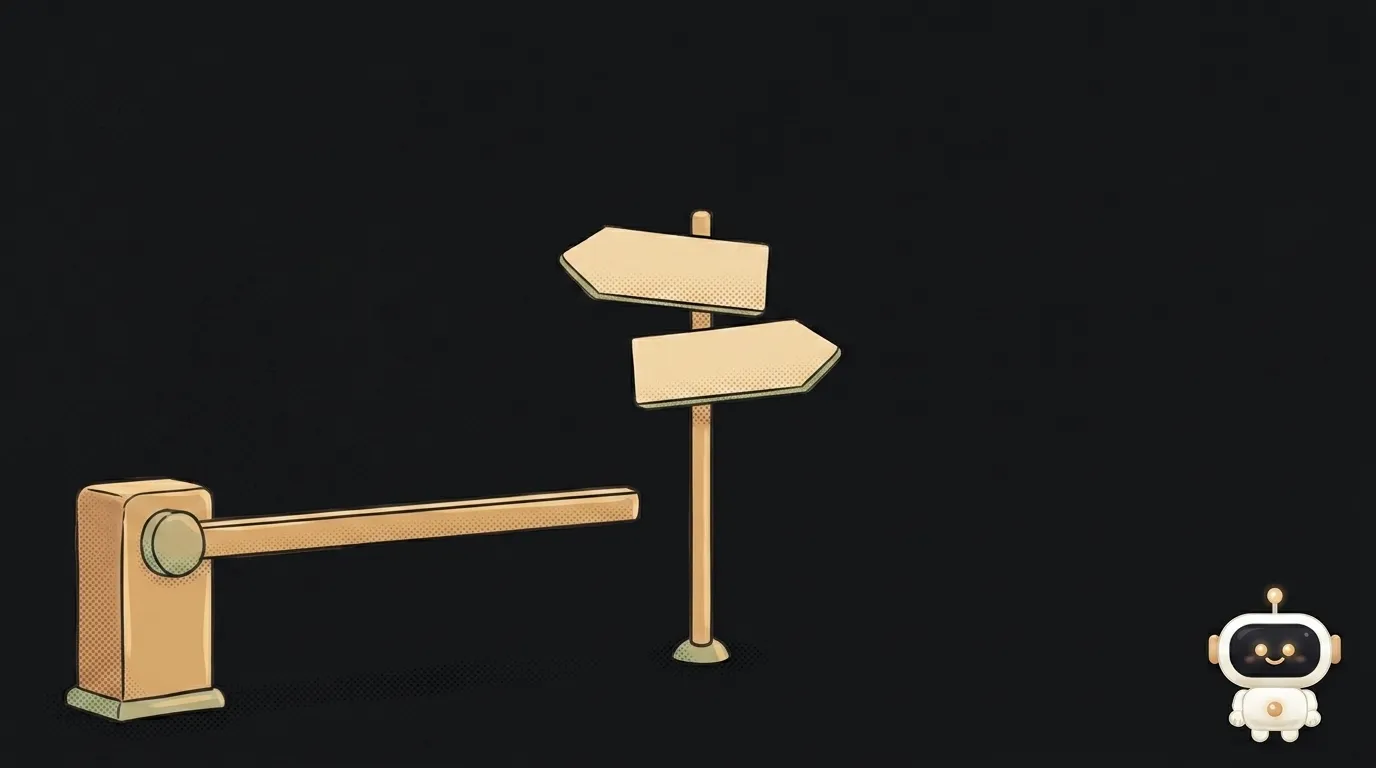
Забор и указатель
robots.txt говорит роботу, куда не ходить. Это ограничение доступа. Google описывает его так: «файл robots.txt сообщает поисковым роботам, к каким адресам на твоём сайте у робота есть доступ», и добавляет — «используется в основном, чтобы не перегружать сайт запросами».
llms.txt делает ровно обратное: он говорит модели, куда идти. Это навигация. Короткий текст в Markdown: что за проект, и список ссылок с пояснениями, зачем каждая нужна.
Забор и указатель. Их можно поставить рядом, но они не заменяют друг друга — и не конкурируют.
Сравнение по пунктам
Кто читает. robots.txt — все поисковые роботы, ИИ-краулеры, парсеры. Проверка этого файла — первое, что делает любой уважающий себя робот. llms.txt — тот, кому ты сам дал адрес: агент, скрипт, инструмент для чтения документации. Обхода «по умолчанию» у него нет.
Насколько обязательно соблюдение. Здесь главная разница. robots.txt соблюдается добровольно, но им пользуются все крупные игроки. Google формулирует честно: «Инструкции в файлах robots.txt не могут заставить робота вести себя определённым образом; соблюдать их — дело робота». llms.txt не соблюдает никто по обязанности: это открытое предложение, а не стандарт.
Что будет, если файла нет. Без robots.txt робот считает, что можно всё, и ходит везде — включая служебные страницы и тяжёлые разделы. Без llms.txt не произойдёт ничего: модель просто прочитает обычный HTML, как и раньше.
Формат. robots.txt — строгие директивы: User-agent, Disallow, Allow, Sitemap. Одна опечатка — и правило не работает. llms.txt — свободный Markdown, обязательная часть ровно одна: заголовок первого уровня с названием проекта.
Где лежит. robots.txt — только в корне сайта, других вариантов нет. llms.txt — в корне или по любому пути, тогда он описывает страницы под этим путём.
Даёт ли что-то для поиска. robots.txt влияет на обход, а через него — на индексацию. llms.txt на поиск не влияет никак: Google в справке для владельцев сайтов пишет прямо — «тебе не нужно создавать новые машиночитаемые файлы, ИИ-текстовики или разметку, чтобы попадать в эти функции».
Кому что подойдёт — прямой ответ
robots.txt ставь всегда. Даже на сайт из пяти страниц. Минимальный файл, который разрешает всё и указывает карту сайта, занимает две строки и снимает вопросы на годы вперёд. Заодно это единственное место, где ты можешь попросить ИИ-краулеров не забирать твой контент.
llms.txt ставь, если у тебя есть документация, API, справка продукта или библиотека — то, что агент читает по твоей наводке. Тогда он получит чистый индекс вместо сорока страниц с меню.
llms.txt не ставь, если цель — «подняться в поиске» или «попасть в ответы ИИ». Ты потратишь вечер и получишь файл, который придётся поддерживать руками. Мёртвый llms.txt со ссылками на удалённые страницы хуже, чем никакого.
Подробный разбор второго файла — в отдельной статье: что такое llms.txt.
Чего не делает ни один из них
Ни тот ни другой не прячет страницу. Про robots.txt это написано в документации прямым текстом: «это не механизм, чтобы убрать веб-страницу из Google». Более того — «страница, закрытая в robots.txt, всё равно может попасть в индекс, если на неё ссылаются с других сайтов».
Если страницу нужно правда скрыть, инструмента два: пароль или метатег noindex. Второй, кстати, работает только если робота пустили прочитать страницу — закрыв её в robots.txt, ты сам мешаешь ему увидеть запрет.
И ни один из них не остановит недобросовестный парсер. Оба файла — просьба, а не замок.
Минимальный robots.txt, который можно положить прямо сейчас
Две строки закрывают вопрос для обычного сайта:
User-agent: *
Allow: /

Sitemap: https://example.com/sitemap.xml
Первая пара разрешает обход всем роботам. Строка с картой сайта — подсказка, откуда брать список страниц; её любят и Google, и Яндекс.
Если нужно закрыть служебный раздел, добавляй Disallow: с конкретным путём — и помни, что это просьба не заходить, а не запрет показывать.
Нужен ли robots.txt маленькому сайту?
Да, хотя бы минимальный. Он снимает лишнюю нагрузку от роботов и указывает путь к карте сайта — это две строки текста.
Можно поставить оба файла сразу?
Можно и часто нужно: они не конфликтуют и живут независимо. Просто не жди, что второй усилит первый.
Заменит ли llms.txt микроразметку?
Нет, это разные слои. Разметка описывает факты внутри конкретной страницы, llms.txt — структуру сайта целиком для чтения моделью.
Курс «Профессия 2027: ИИ-архитектор»: шаг за шагом от основ компьютера до своего приложения и первых клиентов. 543 коротких урока на телефоне.
Читайте дальше

Ed25519 или RSA — какой SSH-ключ выбрать в 2026 году

Что такое sudo — и почему он спрашивает твой пароль, а не пароль админа

Что такое tar.gz — и почему архив tar бывает больше самих файлов

Что такое флаг в команде — и почему git commit -ma ломается, а -am нет

scp или rsync — и почему второй раз rsync отправил 141 байт вместо двух мегабайт
