Голос, которого не было: опиши героя словами — и он заговорит
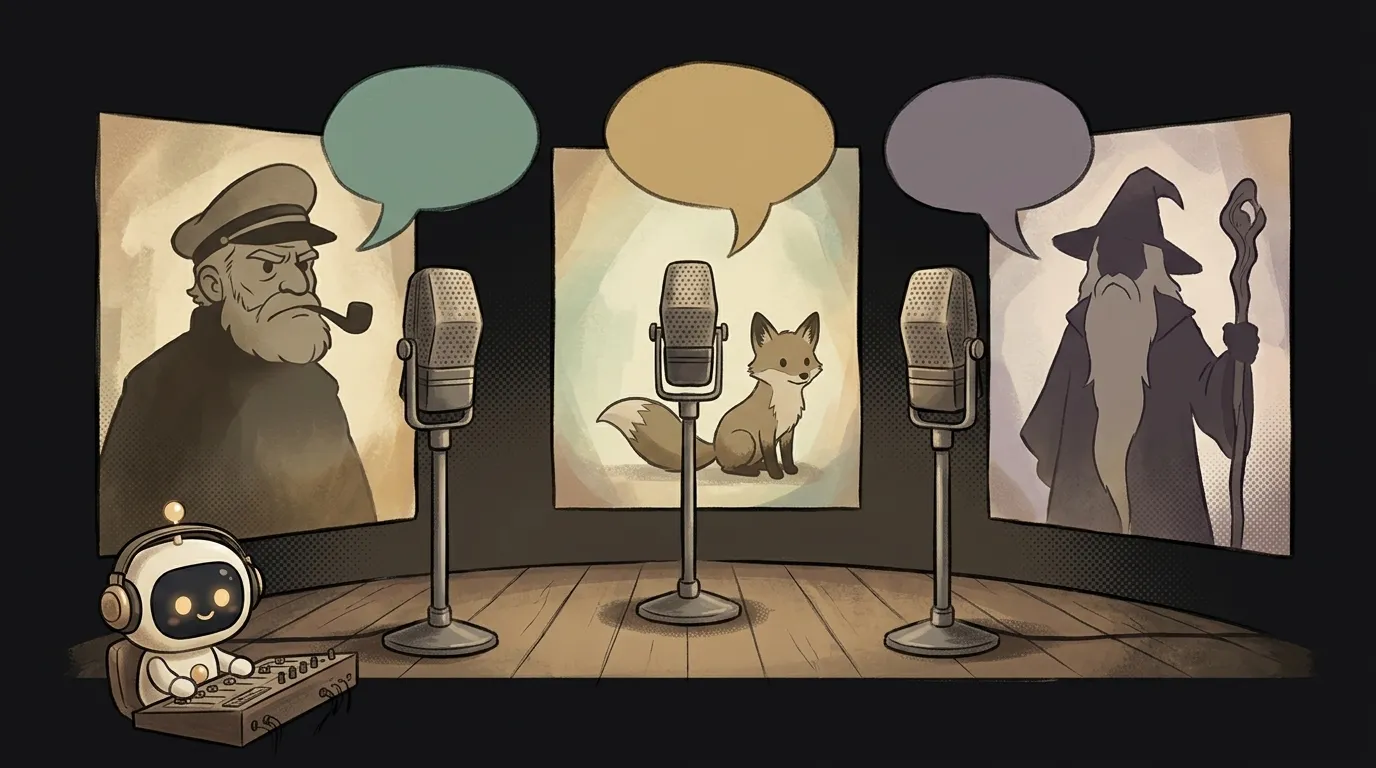
Знакомо? Пишешь сказку для младшего брата. Там капитан, лис и волшебник. Открываешь синтез речи — а там список дикторов: «Мужской 1», «Мужской 2», «Женский 3». Капитан и волшебник звучат как два сотрудника одного колл-центра.
Смотри, что поменялось. У Gemini появился дизайн голоса: ты описываешь голос словами — и модель его создаёт. Не выбирает из списка, а именно создаёт. А 4 ноября добавили ремикс: берёшь готовый голос и правишь его фразой.
Идея в одну строку: маленький сайт-«труппа». Карточка на каждого героя, в ней описание голоса. Жмёшь кнопку — герой заговорил. Потом вставляешь сценарий, и сайт собирает радиоспектакль.
Где тут хитрость
Главное слово — сохраняется. Созданный голос получает свой номер вида voice_.... Это не одноразовая озвучка, а персонаж, который живёт в твоём проекте.
Отсюда три вещи, которых раньше не было:
- Голос не плывёт. Капитан в первой реплике и в двадцатой звучит одинаково. Хоть через месяц.
- Сразу слышно. Вместе с номером приходит короткий образец — WAV-файл. Не понравилось — переписал описание.
- Ремикс вместо нового. «Тот же капитан, но простуженный». Получаешь второй голос, а первый остаётся как был.
Год назад для такого пришлось бы искать актёров. Или клонировать чужой голос — а это уже совсем другой разговор.
Чему научишься
- Описывать звук словами. Тембр, возраст, темп, манера. Это промпт, только для уха.
- Работать с API, у которого есть память. Создал ресурс, получил номер, используешь дальше.
- Разбирать текст по ролям. Строку
КАПИТАН: Полный вперёд!надо отдать нужному голосу. - Склеивать аудио. Реплики по очереди — в один файл.
Готовый стартовый промпт
Ключ Gemini API бесплатно берётся в Google AI Studio. Открой агента в пустой папке и дай задание:
Сделай сайт, который озвучивает сказку разными голосами.Сделай одностраничный сайт «Труппа» на HTML и JS. Ключ Gemini API бери из поля ввода и держи только в памяти страницы. Справа — карточки героев: имя и описание голоса. Кнопка «Создать голос» шлёт POST на /v1beta/voices с type prompted и моим описанием, модель gemini-3.8-flash-tts. Сохрани полученный voice_... в карточке и сразу проиграй образец. Кнопка «Ремикс» создаёт новый голос из этого как базового, с моей правкой словами. Слева — поле сценария в формате «ИМЯ: реплика». Кнопка «Сыграть» озвучивает реплики по очереди голосом своего героя, склеивает в один WAV и даёт скачать. Сначала прочитай документацию Gemini о speech generation и voices и сверь названия полей. Неизвестное имя в сценарии — подсвети строку, не падай.Слабый промпт получит один диктор и кнопку «прочитать». Сильный задаёт главное: голос создаётся один раз, хранится по номеру и потом переиспользуется. И просит агента сверить поля с документацией, а не выдумывать их.
Что в итоге
Три карточки. В первой пишешь: «старый морской капитан, низкий хриплый голос, говорит медленно, будто жуёт трубку». Жмёшь — и через пару секунд слышишь его. Он ворчит.
Во второй — «маленький лис, быстрый, звонкий, немного хитрый». В третьей — волшебник. Вставляешь сказку, жмёшь «Сыграть». Три голоса, которых ещё вчера не существовало, разговаривают друг с другом.
А потом ремикс: «тот же капитан, но в молодости». И у сказки появляется пролог.
Скачиваешь WAV. Отправляешь брату. Он слушает перед сном.
Честно о рамках
- Это не клон человека. Голос придумывается с нуля по описанию. Клонировать чужой голос без спроса — нельзя, и тут это не нужно.
- Эмоции — отдельно. Описание задаёт сам голос. «Шёпотом» или «испуганно» — это настройка конкретной реплики, а не голоса.
- Есть лимит. До 200 сохранённых голосов на проект. Неиспользуемый голос удаляется через год.
- Нужен доступ к Gemini API. Проверь, что AI Studio открывается в твоей стране.
Список дикторов даёт голос. Описание даёт героя.
Курс «Профессия 2027: ИИ-архитектор»: шаг за шагом от основ компьютера до своего приложения и первых клиентов. 543 коротких урока на телефоне.
Источник: Gemini API — changelog: voice remixing для Gemini 3.8 TTS, 4 ноября 2026 · документация speech generation
Читайте дальше
Порепетируй доклад вслух — и узнай, где ты сказал не то, что на слайде
Скажи «убери второе предложение» — и письмо правится само, без мыши
Рассказ на крутилке: двигаешь ползунок — текст переписывается и сам проверяет, послушался ли
Нашивка по одной фразе: агент рисует, машинка вышивает
Своя печатная плата за выходные: агент ведёт провода, KiCad проверяет каждый шаг