Что такое реранкер — и почему поиск по смыслу находит ровно противоположное
Смотри, обидная штука. Ты собрал бота по своей документации. Спрашиваешь: «оплата картой Мир работает?» Бот уверенно отвечает: «Да, работает». А в документации чёрным по белому написано обратное.
Ты лезешь в базу — нужный абзац на месте. Поиск его просто не достал. Или достал, но третьим с конца.
Дело не в модели. Дело в том, что поиск по смыслу сравнивает вовсе не тексты.
Векторный поиск сравнивает два конспекта
Когда ты складываешь документы в векторную базу, каждый кусок текста заранее превращается в эмбеддинг — короткий числовой конспект. Вопрос пользователя превращается в такой же конспект в момент запроса.
Дальше сравниваются только конспекты. Сам текст и сам вопрос друг друга никогда не видят.
Это и есть источник скорости. Документы посчитаны заранее — можно перебрать миллион кусков за десяток миллисекунд. Так устроен любой семантический поиск.
И это же источник промахов. Конспект — сжатие с потерями. А теряется в нём в первую очередь то, что весит мало по буквам, но переворачивает смысл:
- «оплата картой Мир работает» и «оплата картой Мир не работает» — почти одинаковые векторы;
- «подходит для больших файлов, кроме видео» — «кроме видео» размывается;
- «раньше мы поддерживали X» — прошедшее время исчезает.
Отрицание — это одно слово. В конспекте на 1536 чисел оно почти не оставляет следа. Поэтому векторный поиск отлично находит похожее, но не гарантирует правильное.
Реранкер читает вопрос и текст вместе
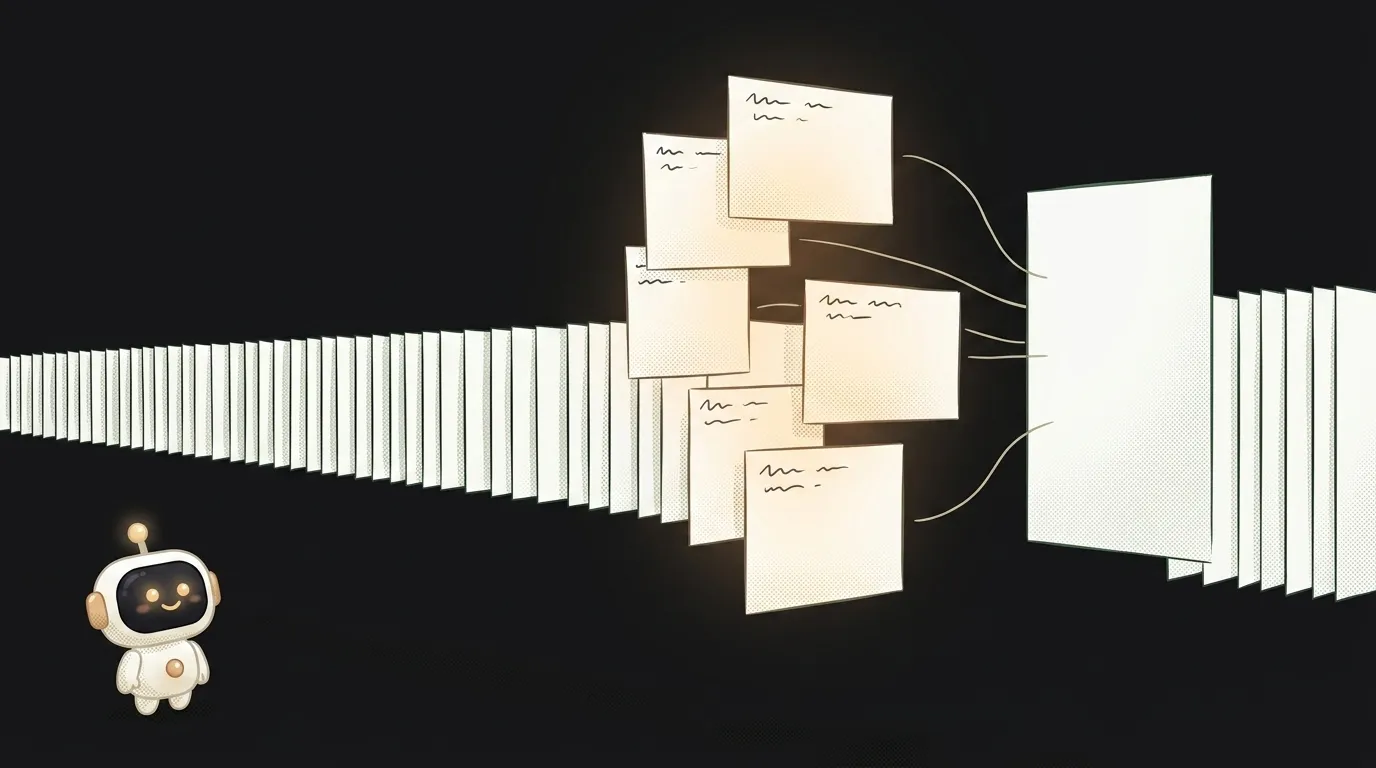
Реранкер устроен иначе. Он берёт пару «вопрос + один кусок текста», склеивает их в один вход и прогоняет через модель целиком. Каждое слово вопроса «смотрит» на каждое слово документа.
Такую модель называют кросс-энкодером — в отличие от би-энкодера, который кодирует обе стороны по отдельности. На выходе не расстояние между конспектами, а одно число: насколько этот текст отвечает на этот вопрос.
Вот тут отрицание и вылезает. Модель видит слово «не» рядом с «работает» и роняет оценку.
Цена — прямая: ничего нельзя посчитать заранее. Вопрос новый каждый раз, значит и модель гоняется заново для каждой пары. По замерам разница в задержке между эмбеддингом и кросс-энкодером — от 4 до 57 раз, порядка 23–330 мс на пару на процессоре.
Умножь на миллион кусков — получишь часы. Поэтому реранкером нельзя искать по всей базе. Он работает только вторым.
Схема, которая работает: достань 50, оставь 5
Рабочий конвейер в RAG выглядит так:
- Векторный поиск достаёт с запасом — не топ-5, а топ-50. Дёшево и быстро.
- Реранкер пересчитывает эти 50 честно, парами.
- В промпт уходят топ-5 после пересчёта.
Ключевое здесь — шаг 1. Первый этап отвечает за то, чтобы нужный кусок вообще попал в полсотни кандидатов. Второй — за то, чтобы он поднялся наверх.
Отсюда важный вывод: если нужного текста нет в топ-50, реранкер бессилен. Он не ищет, он пересортировывает.
Насколько это помогает? В исследовании Anthropic про контекстный поиск связка «контекстные эмбеддинги + поиск по словам» снижала долю неудачных выдач на 49%, а вместе с реранкером — на 67%. То есть две трети промахов уходят.
И встречный вопрос, который задают все: «а если просто взять топ-50 и запихнуть их в промпт целиком?» Так себе идея. Модель хуже держит середину длинного контекстного окна — нужный абзац, оказавшийся в середине простыни, читается хуже, чем первый. Плюс ты платишь за все 50 кусков токенами на каждом запросе.
Когда реранкер не нужен
Не ставь его рефлекторно. Три случая, когда он лишний:
- База маленькая. Если вся твоя документация помещается в контекст модели — не строй поиск вообще, отдай текст целиком.
- Запросы простые и по ключевым словам. «Инструкция по возврату» находится и без пересортировки.
- Задержка критична. Голосовой ассистент, где ответ нужен за секунду, лишние 300 мс почувствует.
Проверяется это одним честным способом. Собери 20–30 реальных вопросов, на каждый запиши, какой кусок текста был правильным ответом, и посмотри две цифры: как часто правильный кусок попадал в топ-5 без реранкера и с ним. Если разницы нет — ты просто купил задержку.
Реранкер — это отдельная модель?
Да, отдельная и маленькая. Есть готовые API (Cohere Rerank, Voyage), есть открытые модели вроде bge-reranker-v2-m3, которые запускаются локально. Генеративная модель для этого не нужна и избыточна.
Можно ли обойтись без него, улучшив эмбеддинги?
Частично. Хорошая нарезка текста и добавление контекста к каждому куску дают больше, чем смена модели эмбеддингов. Но отрицание конспект теряет при любой модели — это свойство подхода, а не качества.
Сколько кандидатов брать на первом этапе?
Начни с 50 и посмотри на замерах. Больше кандидатов — выше шанс, что правильный внутри, но и дольше пересчёт. Ниже 20 обычно бессмысленно: реранкеру нечего пересортировывать.
Дальше логично разобраться, как резать документы на куски — от этого зависит, есть ли вообще в базе кусок, который стоит поднимать наверх. Про это — в гайде про нарезку документов для RAG.
Курс «Профессия 2027: ИИ-архитектор»: шаг за шагом от основ компьютера до своего приложения и первых клиентов. 543 коротких урока на телефоне.
Читайте дальше

Что такое headless-режим ИИ-агента — и почему он молча пропускает шаги

Что такое хук в ИИ-агенте — правило, которое модель не может проигнорировать

Что такое слэш-команда в ИИ-агенте — и почему это просто сохранённый промпт

Что такое навык агента (Agent Skill) — и почему он почти ничего не стоит

Что такое подагент (subagent) — и почему он экономит не время, а контекст
