Что такое UTF-8 — и откуда берутся кракозябры
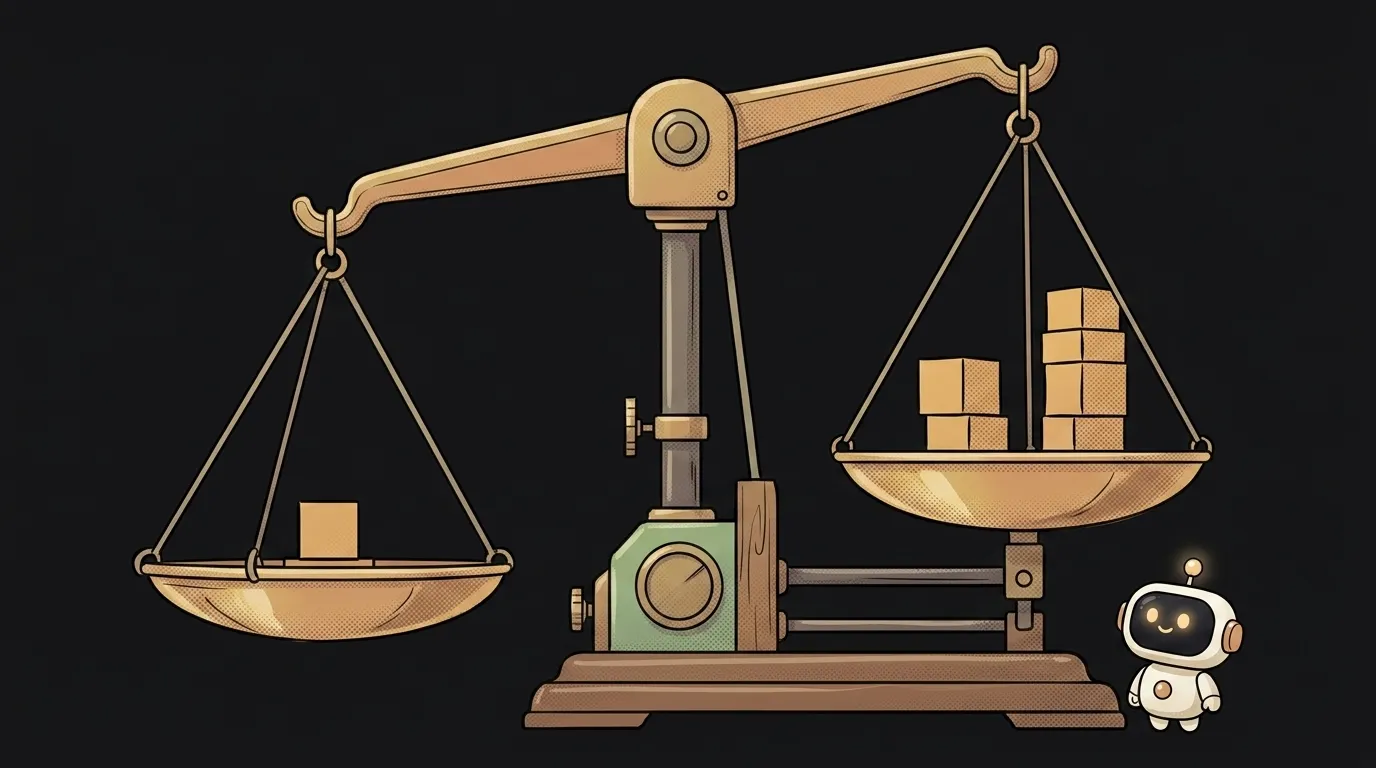
Проверь сам, это занимает секунду. Слово «Привет» — шесть букв. Слово «Hello» — пять. А в памяти компьютера они весят 12 байт и 5 байт.
Русская буква тяжелее английской ровно вдвое. Из этого одного факта растёт половина твоих будущих багов: и кракозябры, и обрезанные на полуслове строки, и «почему запрос на русском стоит дороже».
Почему буква — это не байт
Компьютер хранит только числа. Чтобы хранить текст, нужен договор: какое число какой букве соответствует. Такой договор и называется кодировкой.
Первый договор — ASCII — придумали под английский: 128 символов, каждый в один байт. Латиница, цифры, знаки препинания. Для русского места там не осталось вовсе.
Дальше начался зоопарк: у каждого языка свои таблицы, у русского их было сразу несколько (cp1251, KOI8-R, cp866). Один и тот же байт означал в них разные буквы. Тексты ломались при любом переезде.
UTF-8 — договор, который всех помирил. В нём есть каждый символ на планете: латиница, кириллица, иероглифы, эмодзи, древние алфавиты. Сегодня в UTF-8 живёт подавляющее большинство веба, и все новые проекты по умолчанию используют его.
Почему русский весит вдвое больше
Фокус UTF-8 в том, что символы занимают разное количество байтов:
| Что | Пример | Байт на символ |
|---|---|---|
| Латиница, цифры, знаки | A, 7, ? | 1 |
| Кириллица | П, ж | 2 |
| Иероглифы | 語 | 3 |
| Эмодзи | 🙂 | 4 |
Сделано это ради экономии: английский текст в UTF-8 весит ровно столько же, сколько весил в ASCII, и старые файлы читаются без переделки. Плата за совместимость — всё остальное человечество платит вдвое.
Отсюда, кстати, растёт и знакомая история про цену запросов к моделям. Токенизатор режет текст на кусочки, работая поверх этих самых байтов. Русского текста в байтах больше — значит, и токенов на ту же фразу выходит больше. Одна и та же мысль по-русски стоит дороже, чем по-английски.
Кракозябры — это не порча, а не тот ключ
Вот это стоит запомнить как факт: текст с кракозябрами не испорчен. Байты целы, все до единого. Их просто читают по чужой таблице.
Классика, которую ты наверняка видел:
Привет
Это ровно то же самое «Привет». Его записали в UTF-8, а прочитали как cp1251 — и каждый двухбайтовый русский символ распался на два «однобайтовых». Отсюда фирменные Рџ, СЂ, Рµ в начале каждой пары.
Бывает и наоборот: файл в старой cp1251 читают как UTF-8. Тогда байты не складываются в допустимые символы, и на экране появляется частокол из ��� — «здесь был символ, но я не смог его разобрать».
Диагностика простая:
- Видишь
Рџ,Сѓ,Р°— UTF-8 читают как cp1251. - Видишь
���— cp1251 (или битые байты) читают как UTF-8.
Чинится не «заменой букв», а указанием правильной кодировки при чтении. Менять надо не файл, а ключ к нему.
Где это укусит тебя
Четыре места, где новички теряют вечер:
- Страница без объявления кодировки. Если в
headнет<meta charset="utf-8">, браузер угадывает — и иногда угадывает неверно. Это первое, что надо проверить, если сайт «поехал» на кириллице. - База данных не в той кодировке. Особенно больно в MySQL: старая кодировка с именем
utf8на самом деле неполная и не умеет хранить эмодзи. Нуженutf8mb4. Смайлик в комментарии пользователя валит запрос — и ты долго не понимаешь почему. При создании базы кодировку задают один раз, потом чинить больно. - Обрезка по длине. Если резать строку «первые 100 байт», можно попасть в середину русской буквы — и последний символ превратится в мусор. Резать надо по символам, а не по байтам.
- CSV, открытый в Excel. Файл в UTF-8 Excel по умолчанию читает по-своему, и вся кириллица в таблице превращается в кашу. Лечится сохранением с BOM — специальной меткой в начале файла, по которой Excel понимает кодировку.
Отдельная забавная ловушка: в JavaScript "🙂".length равно двум, хотя символ один. Внутри JS текст хранится иначе, и эмодзи занимает две ячейки. Если считаешь длину сообщения — используй [..."🙂"].length, оно даст честную единицу.
Что забрать с собой
UTF-8 — общая таблица символов для всего мира, где английская буква весит байт, русская два, а эмодзи четыре. Кракозябры — это верные байты, прочитанные не тем ключом.
Практическое правило: везде ставь UTF-8 явно — в meta charset, в кодировке базы, при открытии файла в коде. Не оставляй компьютеру угадывать: он угадывает по-английски. И JSON по стандарту всегда UTF-8 — если оттуда лезут кракозябры, дело точно на твоей стороне.
Чем UTF-8 отличается от Unicode?
Unicode — это сам список символов и их номеров, каталог. UTF-8 — способ записать эти номера байтами. Каталог один, способов записи несколько (есть ещё UTF-16), но в вебе почти всегда используется UTF-8.
Как узнать кодировку файла?
В терминале Linux и macOS помогает команда file -i имя.txt. В нормальном редакторе (VS Code) текущая кодировка написана в строке состояния снизу — и там же её можно переоткрыть в другой.
Нужен ли BOM в начале файла?
Для веба — нет, и лучше без него: лишние байты в начале иногда ломают вывод страницы. Единственный частый случай, когда BOM нужен, — CSV, который будут открывать в Excel.
Курс «Профессия 2027: ИИ-архитектор»: шаг за шагом от основ компьютера до своего приложения и первых клиентов. 543 коротких урока на телефоне.
Читайте дальше

Ed25519 или RSA — какой SSH-ключ выбрать в 2026 году

Что такое sudo — и почему он спрашивает твой пароль, а не пароль админа

Что такое tar.gz — и почему архив tar бывает больше самих файлов

Что такое флаг в команде — и почему git commit -ma ломается, а -am нет

scp или rsync — и почему второй раз rsync отправил 141 байт вместо двух мегабайт
