Почему запрос к базе тормозит — и почему на твоих данных он был быстрым
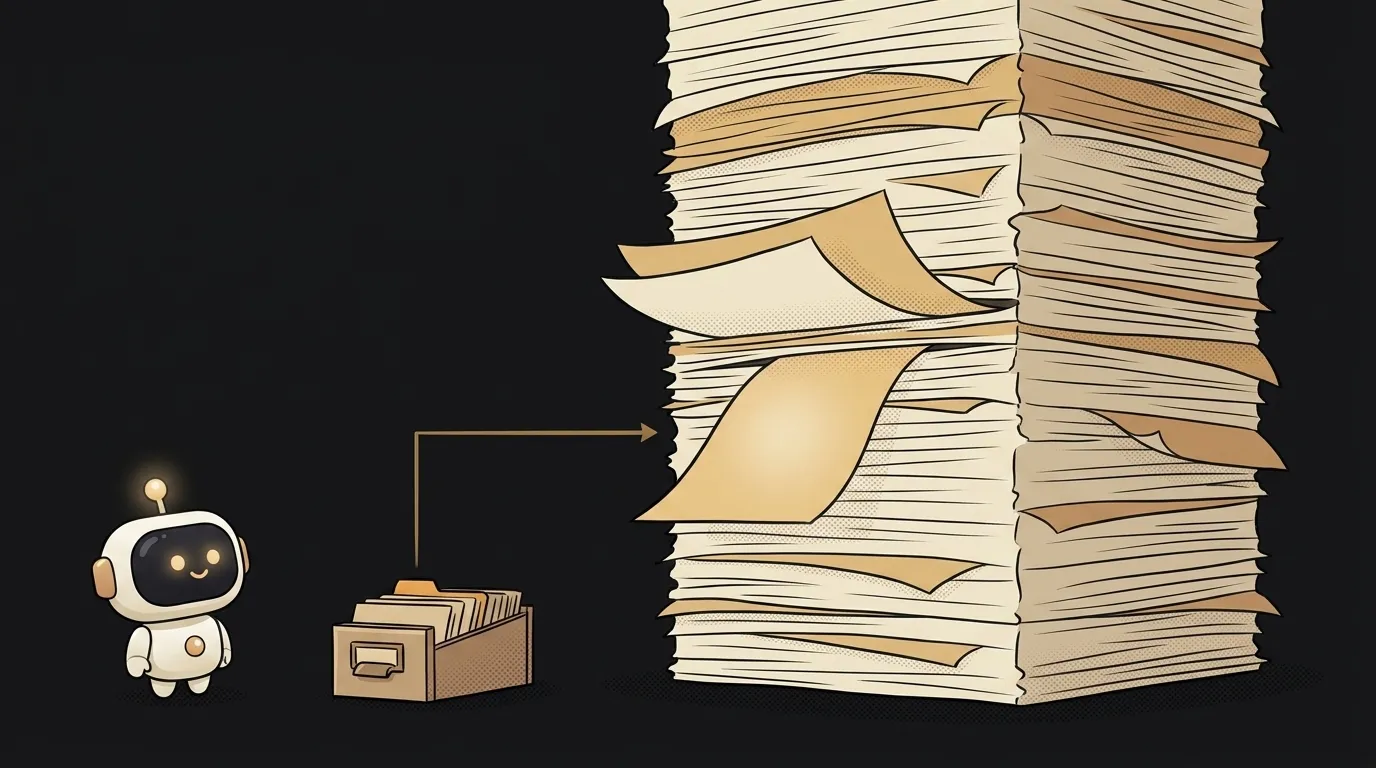
Симптом узнаваемый: локально страница открывалась мгновенно. В проде она думает восемь секунд, а иногда отваливается по таймауту. Код не менялся. Изменились только данные — их стало больше.
И вот что здесь важно понять сразу. Данных стало больше в тысячу раз, а запрос стал медленнее в десять тысяч. Рост не линейный — он обваливается ступенькой. Причина почти всегда одна из трёх, и первая покрывает большинство случаев.
Сначала измерь, а не угадывай
Прежде чем что-то менять — попроси базу объяснить, что она делает. В Postgres и MySQL перед запросом пишут EXPLAIN ANALYZE:
EXPLAIN ANALYZE SELECT * FROM orders WHERE user_id = 42;
База покажет план: как именно она искала и сколько это заняло. Читать весь план не нужно, ищи два слова.
Seq Scan(в MySQL —type: ALL) — «последовательное чтение». База прочитала таблицу целиком.Index Scan— нашла по индексу, сразу и точно.
Всё. Дальше — по причинам.
Причина 1: нет индекса — база читает всю таблицу
Самая частая, с большим отрывом.
Что происходит. Без индекса база не умеет «найти» строку. У неё нет выбора, кроме как просмотреть каждую строку и проверить условие. Сто строк — незаметно. Сто тысяч — она читает сто тысяч, каждый раз заново. На каждый запрос каждого пользователя.
Индекс — это как алфавитный указатель в конце книги. Без него ты ищешь слово, перелистывая все страницы подряд. С ним — открываешь указатель, видишь «страница 287» и идёшь туда.
Как проверить. EXPLAIN ANALYZE показал Seq Scan на большой таблице — вот оно.
Как починить. Создай индекс по колонке, по которой фильтруешь или соединяешь:
CREATE INDEX idx_orders_user_id ON orders(user_id);
Правило, которое закрывает почти всё: индекс нужен каждой колонке, которая стоит в WHERE, JOIN или ORDER BY. Проверь свои запросы — почти наверняка у половины индекса нет.
Почему это не делают по умолчанию для всех колонок? Индекс — отдельная структура, её надо обновлять при каждой записи. Много лишних индексов замедляют вставку и занимают место. Поэтому их ставят осознанно, по своим запросам.
Причина 2: N+1 — не один медленный запрос, а пятьсот быстрых
Вторая по частоте, и её почти невозможно заметить в коде — он выглядит чисто.
Что происходит. Ты получил список из 100 заказов. Потом в цикле для каждого заказа запросил пользователя. Итого 101 запрос вместо двух. Каждый быстрый, по 3 мс. Но 101 обращение по сети к базе — это уже треть секунды на пустом месте, а в проде, где база на другом сервере, — секунды.
Особенно легко попасть, если используешь ORM: order.user.name внутри цикла выглядит как обращение к полю, а под капотом это отдельный запрос к базе.
Как проверить. Включи логирование SQL и открой страницу один раз. Видишь сотню почти одинаковых запросов, отличающихся только id — это N+1.
Как починить. Забрать всё за один запрос вместо цикла:
- в ORM — «жадная» загрузка (
include,selectсо связью,prefetch_related— название зависит от библиотеки); - на чистом SQL —
JOINилиWHERE user_id IN (...)одним запросом.
Причина 3: тащишь лишнее по сети
Самая безобидная, но встречается постоянно.
Что происходит. SELECT * забирает все колонки, включая те, что тебе не нужны: длинные описания, base64-картинки, JSON-поля на десятки килобайт. Для списка, где ты показываешь только имя и дату, база честно упакует и передаст всё.
Сюда же — запрос без LIMIT. Показываешь двадцать последних заказов, а забираешь все сорок тысяч и обрезаешь в коде.
Как проверить. Посмотри на время: сам запрос в базе быстрый (EXPLAIN доволен), а до приложения ответ идёт долго. Значит, дело в объёме передаваемых данных.
Как починить. Перечисляй колонки явно и ставь LIMIT:
SELECT id, created_at, total FROM orders
WHERE user_id = 42
ORDER BY created_at DESC
LIMIT 20;
Если запрос честно тяжёлый и его результат меняется редко, дальше помогает кэш — но только после того, как убрал первые три причины. Кэшировать медленный запрос — это спрятать проблему, а не решить.
Частые вопросы
Как понять, что пора добавлять индекс?
Не по размеру таблицы, а по плану запроса. EXPLAIN ANALYZE показал Seq Scan там, где ты ищешь конкретные строки — пора. На таблице в тысячу строк это тоже сработает, просто разницы ты не почувствуешь.
Индексы могут сделать хуже?
Да, при записи: каждый INSERT и UPDATE обновляет все индексы таблицы. Для обычного приложения, где читают гораздо чаще, чем пишут, выигрыш многократно перекрывает потери. Проблема начинается при десятке индексов на одной таблице.
Стоит ли переехать на «более быструю» базу?
Почти никогда. В подавляющем большинстве случаев тормозит не база данных, а запрос без индекса — и переезд просто перевезёт проблему на новое место. Сначала EXPLAIN ANALYZE, потом выводы.
Курс «Профессия 2027: ИИ-архитектор»: шаг за шагом от основ компьютера до своего приложения и первых клиентов. 543 коротких урока на телефоне.
Читайте дальше

Почему SSH всё равно просит пароль, хотя ключ настроен — 3 причины

Как настроить ~/.ssh/config — короткие имена серверов вместо длинных команд

Почему SSH отключается сам (Broken pipe) — три причины и как починить

Как читать справку команды (--help и man) — и узнать флаги своей версии за минуту

Почему Ctrl+C не останавливает программу — и как одна строка except это делает
