Что такое фильтр Блума — структура, которая врёт, но только в одну сторону
Вот странная штука. Есть структура данных, которая иногда ошибается — и её всё равно ставят в серьёзные базы данных. Специально.
Секрет в том, как она ошибается. Фильтр Блума может сказать «возможно, есть», когда элемента нет. Но если он сказал «точно нет» — это правда всегда. И за эту одностороннюю ложь он берёт около 10 бит на элемент. Не 10 байт — 10 бит.
Что такое фильтр Блума простыми словами
Фильтр Блума отвечает на один вопрос: «этот элемент уже встречался?» Ответов два:
- «Точно нет» — гарантия.
- «Возможно, да» — надо перепроверить в настоящем хранилище.
Сам элемент фильтр не хранит. Только отпечаток из нескольких битов. Поэтому он маленький — и поэтому не может ответить «точно да».
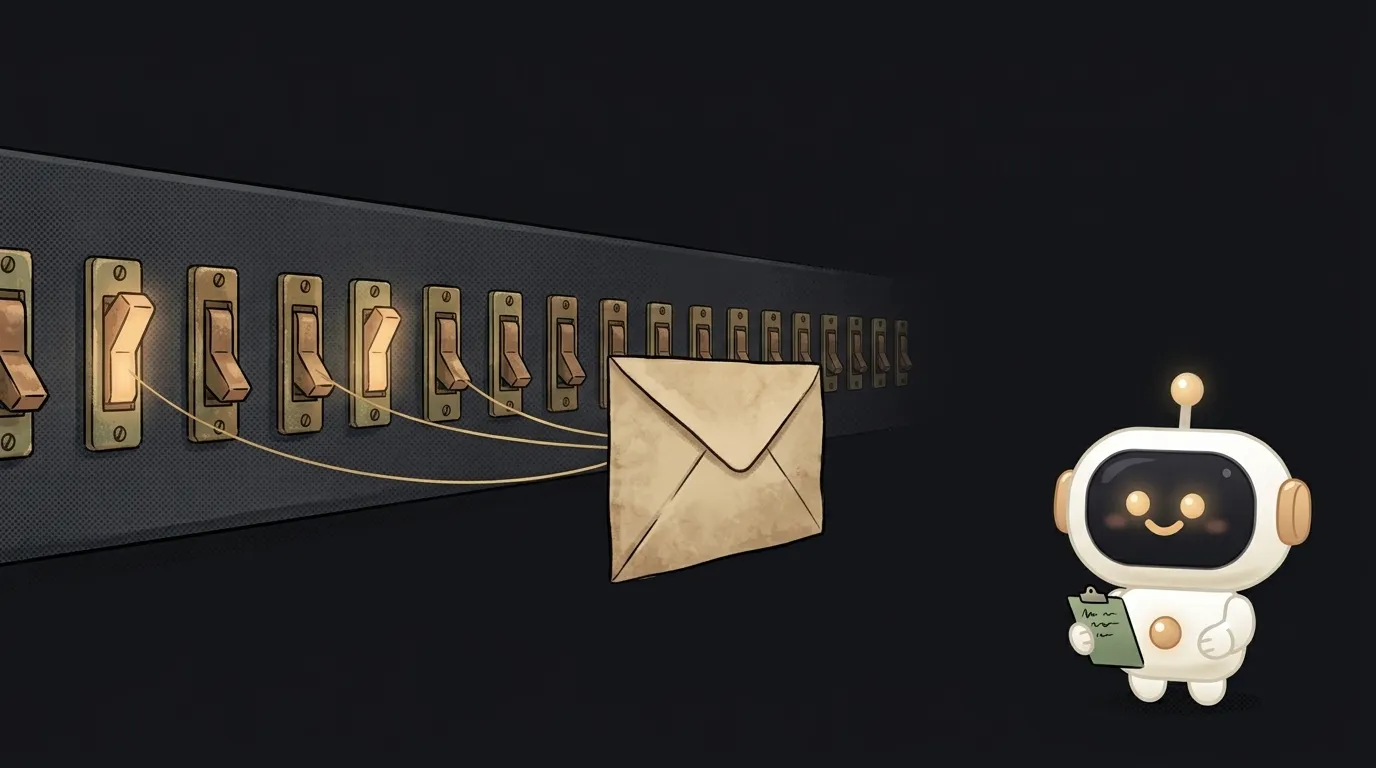
Представь стену с рядом выключателей, все выключены. Каждому письму соответствуют три выключателя — их выбирает формула по адресу. Пришло письмо — щёлкаешь его три выключателя вверх. Хочешь узнать, было ли письмо? Смотришь на его три выключателя. Хоть один внизу — письма не было, точно. Все три вверху — наверное, было. А может, их по одному включили три других письма.
Как это работает
Внутри — массив битов и несколько хеш-функций. Хеш превращает строку в число — номер бита.
- Добавить
"кот": три хеша дают, скажем, 2, 7 и 11. Ставишь эти три бита в 1. - Добавить
"дом": хеши дают 4, 7 и 13. Бит 7 уже стоял — не страшно. - Проверить
"лес": хеши дают 2, 9 и 13. Бит 9 — ноль. Значит, «лес» точно не добавляли. - Проверить
"сад": хеши дают 2, 4 и 11. Все три — единицы. Фильтр говорит «возможно». Но «сад» никто не добавлял! Биты зажгли «кот» и «дом». Это и есть ложное срабатывание.
Чем больше массив на один элемент, тем реже такие совпадения. Классическая цифра: около 9,6 бита на элемент дают 1% ложных «да». Причём от длины самих элементов это не зависит. Хоть короткие логины, хоть длинные URL.
Для масштаба: миллиард элементов при 1% ошибок — примерно 1,2 ГБ. Сами строки заняли бы в разы больше.
Зачем это тебе
Фильтр стоит перед дорогой проверкой и отсекает заведомо лишнюю работу.
- «Логин свободен?» Пользователь печатает имя, и ты хочешь подсказывать на лету. Фильтр говорит «точно нет» — имя свободно, в базу не ходим. Говорит «возможно» — проверяем в базе данных. Большинство вариантов отсекаются без запроса.
- «Уже показывали?» Лента не должна дважды показывать одну статью. Фильтр на пользователя помнит тысячи просмотренных за пару килобайт.
- «Есть ли в кэше?» Перед медленным походом на диск или в сеть. Это родственник кэширования: не хранить ответ, а знать, где его точно нет.
Три правила, которые стоит запомнить:
- Ошибки только в сторону «возможно, да». Если для тебя опасно именно это — фильтр не подходит.
- Из обычного фильтра нельзя удалить элемент. Сбросишь его биты — заденешь соседей. Для удаления есть вариант со счётчиками вместо битов.
- Размер считай заранее. Переполненный фильтр, где почти все биты — единицы, на всё отвечает «возможно» и становится бесполезным.
Где ты его встретишь
- Cassandra, HBase и другие базы на LSM-деревьях. У каждого файла данных на диске свой фильтр. Ищешь ключ — база сначала спрашивает фильтры и не открывает файлы, где ключа «точно нет». Процент ошибок в Cassandra настраивается параметром таблицы
bloom_filter_fp_chance. - Postgres. Есть расширение
bloom— индекс на фильтре Блума для запросов по многим колонкам сразу. - Чёрные списки. Быстрая локальная проверка «этот адрес точно не в списке опасных», прежде чем спрашивать сервер.
- Redis — через модуль с командами
BF.ADDиBF.EXISTS.
Чем фильтр Блума отличается от Set?
Set хранит сами элементы и отвечает точно, но растёт вместе с данными. Фильтр хранит только биты и занимает фиксированный объём, но может ошибиться в сторону «да». Пока данные влезают в память — бери Set.
Можно ли получить из фильтра список элементов?
Нет. По битам нельзя восстановить, что добавляли. Это одновременно ограничение и плюс: фильтр не раскрывает сами данные.
Сколько хеш-функций нужно?
Для 1% ошибок оптимально около семи. Больше хешей — каждый элемент зажигает больше битов, и массив заполняется быстрее. Готовые библиотеки считают число сами по нужному проценту ошибок.
Короткие уроки-истории, симулятор агента и ежедневная практика — в нашем мобильном приложении. Бесплатно.
Читайте дальше
Что такое LRU-кэш — и почему кэш без лимита превращается в утечку памяти
Что такое скользящее окно — приём, который считает «лучшую неделю» за один проход
encodeURI или encodeURIComponent — в чём разница и почему «Tom & Jerry» ищется как «Tom»
Что такое кольцевой буфер — и почему старые логи исчезают сами
Что такое heartbeat — и почему «открытое» соединение может быть давно мёртвым