Что такое кольцевой буфер — и почему старые логи исчезают сами
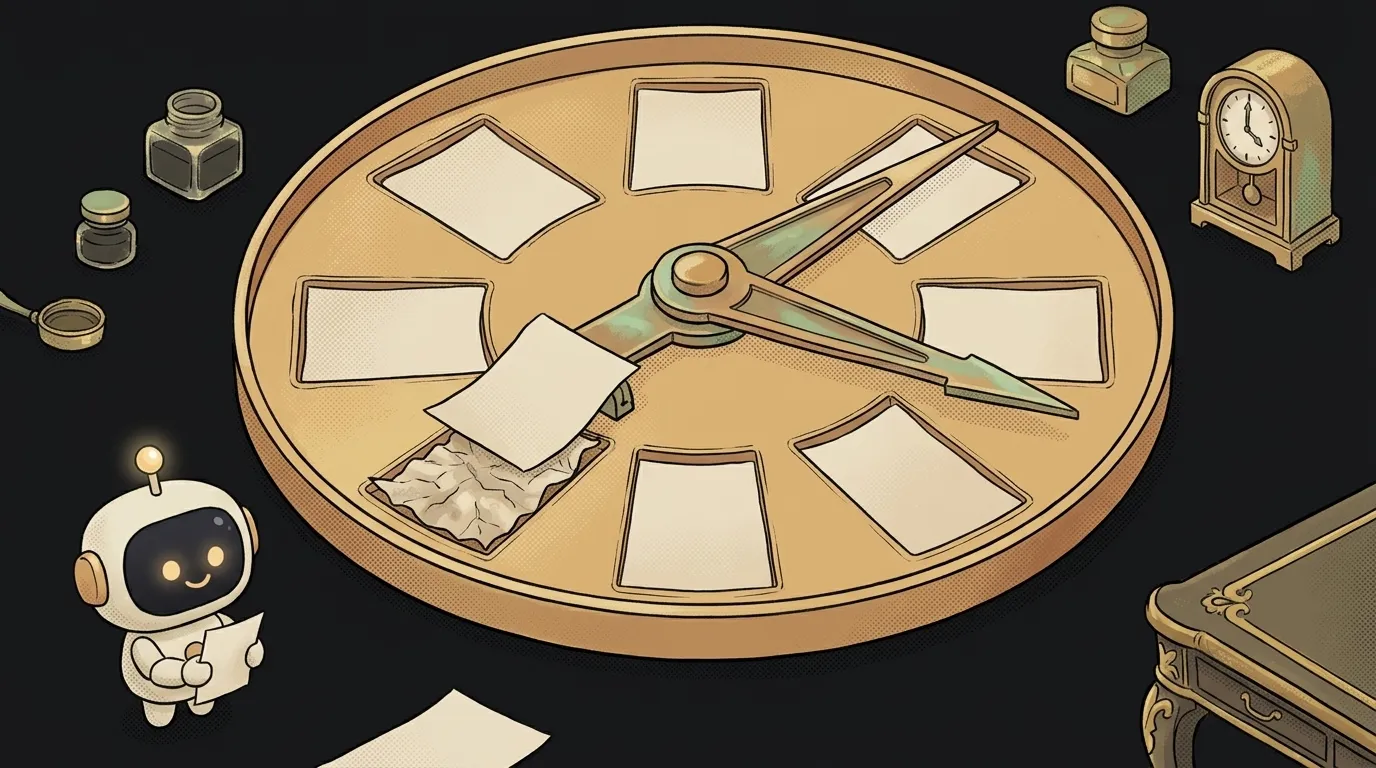
Открой терминал на Linux и набери man dmesg. Первая строка описания: «print or control the kernel ring buffer». Смотри, что это значит: ядро твоей системы пишет свои сообщения в кольцо. Когда кольцо заполнено, новое сообщение молча затирает самое старое.
Никто ничего не удаляет. Никакой уборки по расписанию. Память под логи просто не растёт — никогда. Это и есть кольцевой буфер. И он пригодится тебе гораздо раньше, чем ядро.
Что такое кольцевой буфер
Кольцевой буфер — это массив фиксированного размера, который пишут по кругу. Дошёл до конца — продолжаешь с начала, поверх самых старых данных.
Представь круглый стол на 5 мест. Гости садятся по очереди. Пришёл шестой — садится на место первого, а первый уходит. За столом всегда сидят пятеро самых свежих.
Отсюда главное свойство: буфер хранит последние N элементов. Не больше. Сколько бы данных ни пришло, памяти он занимает ровно столько, сколько ты выделил в начале.
Как он работает
Внутри всего три вещи: массив нужной длины, указатель «куда писать» и счётчик заполненности.
class RingBuffer {
  constructor(size) {
    this.items = new Array(size);
    this.size = size;
    this.next = 0;   // куда писать дальше
    this.count = 0;  // сколько уже заполнено
  }
  push(item) {
    this.items[this.next] = item;
    this.next = (this.next + 1) % this.size; // вот и всё кольцо
    this.count = Math.min(this.count + 1, this.size);
  }
  toArray() {
    const start = (this.next - this.count + this.size) % this.size;
    return Array.from({ length: this.count }, (_, i) =>
      this.items[(start + i) % this.size]
    );
  }
}
Вся магия — в % this.size. Остаток от деления возвращает указатель в ноль, когда он доходит до конца. Индексы бегут 0, 1, 2, 3, 4, 0, 1… Никакого сдвига элементов.
Проследи руками на буфере из трёх ячеек. Пишешь a, b, c — массив [a, b, c], указатель вернулся в 0. Пишешь d — он ложится в ячейку 0: [d, b, c], указатель теперь 1. В памяти порядок «сломан», но toArray() начинает с самой старой записи и отдаёт b, c, d. То есть хранение и чтение — две разные вещи: внутри кольцо, снаружи обычный список.
Именно поэтому, если ты заглянешь в такой массив в отладчике, он покажется перемешанным. Это не баг. Начало списка — там, куда указывает next, а не в нулевой ячейке.
А теперь сравни с привычным способом «держать последние 100»:
logs.push(entry);
if (logs.length > 100) logs.shift();
Выглядит невинно. Но shift() по стандарту переставляет все оставшиеся элементы на одну позицию влево. Сто записей — сто перестановок на каждое новое событие. Кольцу же всё равно: одна запись в ячейку, и готово.
Зачем это тебе
Кольцевой буфер нужен везде, где важна свежесть, а история — нет.
- Последние логи в приложении. Держишь 200 последних событий в памяти. Пользователь жмёт «Сообщить об ошибке» — и ты прикладываешь их к отчёту. Так же устроены «хлебные крошки» в сервисах отслеживания ошибок. Подробнее про сами записи — в статье про логи.
- История для ИИ-бота. Хочешь, чтобы бот помнил 20 последних реплик и не раздувал запрос? Кольцо на 20 — и контекст никогда не вырастет сам по себе.
- Скользящее среднее. Показать среднюю скорость загрузки за последние 10 замеров. Новый замер затирает самый старый, и среднее всегда «про сейчас».
- Звук и видео. Аудиопоток приходит кусками, а играется ровно. Между ними сидит буфер по кругу: один пишет, другой читает.
Если тебе нужно не «последнее», а «самое важное», это уже другая структура — очередь с приоритетом.
Подвох: что делать, когда буфер полон
Есть два честных варианта, и выбрать надо осознанно.
- Затирать старое. Как в примере выше. Хорошо для логов и метрик: потерять старую запись не страшно.
- Отказывать новому.
pushвозвращаетfalse, пока читатель не освободит место. Так делают, когда терять данные нельзя — например, с аудио или командами.
Самая частая ошибка новичка — смешать оба режима. Писатель затирает данные, которые читатель ещё не успел прочитать. Получаются «пропавшие» события, которые не воспроизводятся в отладке.
Чем кольцевой буфер отличается от обычной очереди?
Обычная очередь растёт, пока ты из неё не читаешь. Кольцевой буфер имеет потолок: при заполнении он либо затирает старое, либо отказывает новому.
Какой размер выбрать?
Посчитай от задачи: сколько событий реально нужно, чтобы понять ошибку или ответить пользователю. Для логов в браузере обычно хватает 50–200 — дальше это уже шум.
Есть ли кольцевой буфер в JavaScript из коробки?
Готового класса нет. Но он умещается в 20 строк, как выше, — и это хорошая первая структура данных, чтобы написать самому.
Короткие уроки-истории, симулятор агента и ежедневная практика — в нашем мобильном приложении. Бесплатно.
Читайте дальше
Что такое heartbeat — и почему «открытое» соединение может быть давно мёртвым
Что такое очередь недоставленных сообщений (DLQ) — и как одно битое письмо держит всю очередь
border или outline — в чём разница и почему от рамки при наведении всё прыгает
Что такое trie (префиксное дерево) — и почему подсказка не перебирает весь словарь
Что такое очередь с приоритетом — и почему её массив выглядит неотсортированным