Что такое косинусное сходство — и почему 0,8 не значит «совпало на 80%»
Ты собрал поиск по смыслу, он выдаёт результаты с оценками: 0,86, 0,81, 0,79. Ставишь порог 0,5 — «ну, половина же» — и в выдачу лезет всё подряд.
Так вот: 0,8 здесь не означает «совпало на 80%». Это вообще не проценты. И именно из-за этого недопонимания пороги ставят наугад, а потом удивляются мусору в результатах. Давай разберёмся, что это за число.
Косинус измеряет направление, а не расстояние
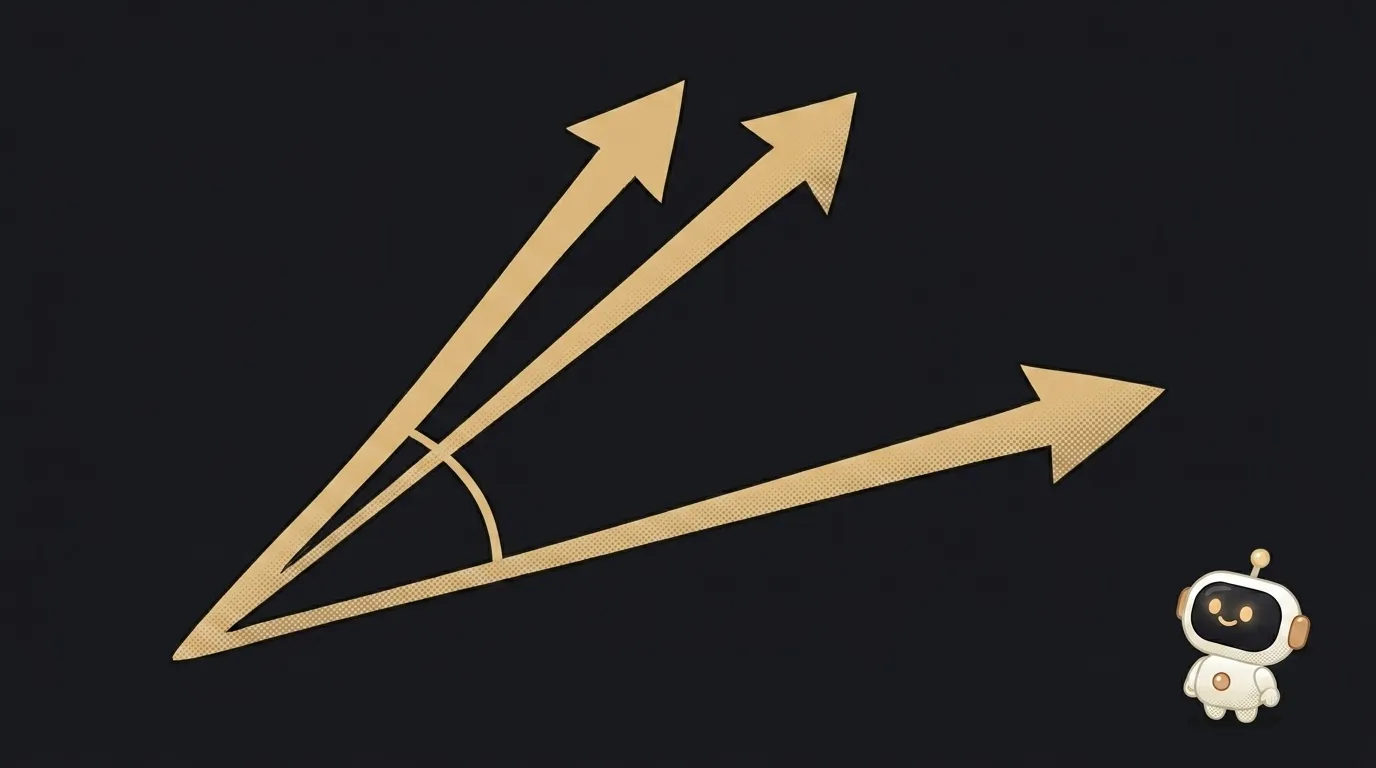
Любой текст эмбеддинг превращает в длинный список чисел — вектор. Геометрически это стрелка, торчащая из начала координат в какую-то сторону.
У стрелки есть две характеристики: куда она направлена и насколько она длинная. Косинусное сходство смотрит только на первое. Оно измеряет угол между двумя стрелками и полностью игнорирует их длину.
Почему это важно, видно на примере. Возьми короткую заметку «как заварить чай» и подробную статью на три страницы про то же самое. Вторая длиннее, её вектор «мощнее». Если мерить обычное расстояние между концами стрелок, длинный текст окажется далеко от короткого — просто потому, что он длинный. Смысл-то один, а метрика скажет «не похоже».
Косинус на это не покупается. Обе стрелки смотрят примерно в одну сторону — угол маленький — значит, тексты про одно и то же. Ровно поэтому он и стал стандартом для поиска по смыслу.
Шкала такая: 1 — стрелки смотрят строго в одну сторону, 0 — под прямым углом, никакой связи, −1 — в противоположные.
Почему в векторной базе можно не выбирать метрику
Теперь неожиданная штука, которая экономит кучу времени на спорах.
Формула косинуса — это скалярное произведение векторов, делённое на их длины. А почти все провайдеры эмбеддингов отдают векторы уже нормализованными — то есть приведёнными к длине ровно 1.
Делить на единицу бессмысленно. Значит, для нормализованных векторов косинусное сходство буквально равно скалярному произведению.
OpenAI пишет об этом в документации прямо: их эмбеддинги нормализованы к длине 1, поэтому косинус можно считать быстрее — как скалярное произведение, — и результат будет тот же. Более того, порядок результатов совпадёт и с евклидовым расстоянием.
Вывод практический: если твои векторы нормализованы, спор «косинус или скалярное произведение или евклид» — пустой. Ранжирование получится одинаковое, отличается только скорость вычисления. Выбирай то, что быстрее в твоей векторной базе, и иди дальше.
Так что означают сами числа
А вот здесь придётся принять неприятную правду: абсолютное значение косинуса само по себе не значит почти ничего.
Причина в том, что векторы текстовых эмбеддингов не разбросаны по всему пространству равномерно. Они кучкуются. Два случайных, никак не связанных текста на одном языке всё равно имеют общее — грамматику, стиль, саму «текстовость» — и их косинус будет заметно выше нуля, а не около него.
Насколько выше — зависит от конкретной модели эмбеддингов. Поэтому 0,5 у одной модели может означать «вообще ни при чём», а у другой — «вполне релевантно».
Хуже того: распределения похожих и непохожих пар перекрываются. В кукбуке OpenAI это показано наглядно — на графиках видно, что некоторые непохожие пары набирают косинус выше, чем некоторые похожие. Идеального порога, который разделит их без ошибок, просто не существует.
Как ставить порог по-человечески
Не угадывать, а измерить. Порядок такой:
- Собери 20–30 реальных запросов — тех, что вводят живые пользователи, а не выдуманных.
- Прогони поиск и посмотри на выдачу целиком — с оценками, без отсечки.
- Отметь глазами, где кончается полезное и начинается мусор. У тебя получится вилка — например, «нужное выше 0,74, ненужное ниже 0,71».
- Поставь порог по нижней границе полезного и перепроверь на новых запросах.
И держи в голове альтернативу порогу: часто надёжнее брать не «всё выше X», а фиксированные топ-5 результатов и передавать их модели. Тогда числа вообще не нужны — важен только порядок. Для RAG это обычно и есть правильный режим.
Почему косинус бывает отрицательным, а на практике не встречается?
Математически шкала идёт от −1 до 1, и −1 означало бы «противоположный смысл». Но у текстовых эмбеддингов такое почти не встречается: модель кодирует не «за и против», а тему. Тексты «я люблю кофе» и «я ненавижу кофе» окажутся очень похожими — они оба про кофе.
Нужно ли нормализовать векторы самому?
Если их отдаёт готовый API — как правило, нет, они уже нормализованы. Если ты обучал модель сам или взял её с Hugging Face — проверь: посчитай длину пары векторов, и если она не равна примерно 1, нормализуй перед сравнением. Иначе скалярное произведение перестанет совпадать с косинусом, и длинные тексты начнут выигрывать просто за счёт длины.
Курс «Профессия 2027: ИИ-архитектор»: шаг за шагом от основ компьютера до своего приложения и первых клиентов. 543 коротких урока на телефоне.
Читайте дальше

Ed25519 или RSA — какой SSH-ключ выбрать в 2026 году

Что такое sudo — и почему он спрашивает твой пароль, а не пароль админа

Что такое tar.gz — и почему архив tar бывает больше самих файлов

Что такое флаг в команде — и почему git commit -ma ломается, а -am нет

scp или rsync — и почему второй раз rsync отправил 141 байт вместо двух мегабайт
