Что такое GGUF — и как читать имя файла модели вроде Q4_K_M
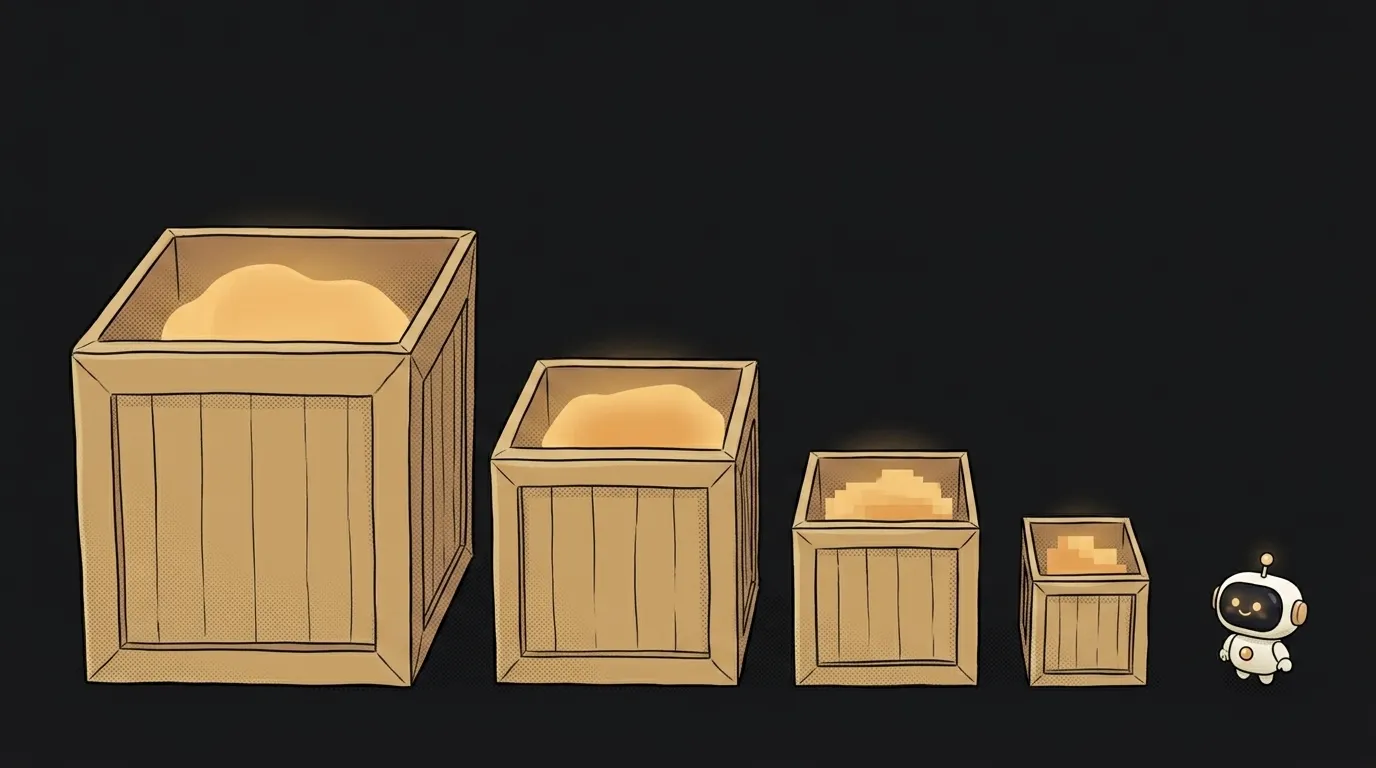
Заходишь скачать модель — а там не файл, а список из дюжины. Одно и то же название, но: 16 ГБ, 8.5 ГБ, 4.9 ГБ, 3.2 ГБ. И хвосты вроде Q4_K_M, Q5_K_S, Q8_0.
Неожиданная штука: это одна и та же модель. Не «младшая» и «старшая», не разные версии. Одни и те же знания, упакованные с разной грубостью. И выбор между ними — это выбор между «влезет в мой ноутбук» и «будет чуть умнее».
Разберём имя файла по буквам, чтобы качать осознанно.
Что такое GGUF
GGUF — это формат файла, в котором модель лежит на диске. Не архитектура, не компания, не «версия ИИ». Просто контейнер, как .mp4 для видео.
Придумали его в проекте llama.cpp — том самом движке, на котором крутятся почти все локальные модели. И главная его идея — всё в одном файле.
Внутри лежат:
- сами веса модели (то, чему она научилась),
- токенизатор (как резать текст на кусочки),
- метаданные: архитектура, шаблон промпта, размер контекста.
Звучит скучно, пока не вспомнишь, как было раньше: веса отдельно, конфиг отдельно, токенизатор отдельно, и половина проблем — «а этот конфиг от той версии». Теперь ты качаешь один файл, и он самодостаточен.
Второе отличие от открытых весов в исходном виде: файлы .safetensors на HuggingFace рассчитаны на видеокарту и полную точность. GGUF рассчитан на то, чтобы работать на обычном железе — с процессора, с частичной выгрузкой на видеокарту, на «маке из магазина».
Как читать Q4_K_M по буквам
Вот та самая расшифровка, которую почему-то нигде не пишут рядом со ссылкой на скачивание.
Q4_K_M
- Q4 — сколько битов на один вес. Было 16, стало 4. Это и есть квантизация — числа внутри модели огрубляют, и файл ужимается в разы.
- K — метод «k-quant»: модель бьётся на блоки, и внутри блока разные части хранятся с разной точностью. Важное — точнее, остальное — грубее. Умнее, чем резать всё подряд одинаково.
- M — размер варианта: S (small), M (medium), L (large). Это про то, сколько блоков оставили поточнее. S меньше и глупее, L больше и умнее.
Отдельно стоит Q8_0 — 8 бит, старый простой метод без «K». Почти как оригинал по качеству и вдвое тяжелее Q4.
Теперь всё имя читается целиком: llama-3-8b-instruct.Q4_K_M.gguf — это модель на 8 миллиардов параметров, обученная отвечать на инструкции, ужатая до 4 битов методом k-quant в среднем варианте.
Какой файл качать
Правило одно, и оно про железо, а не про качество.
Модель должна целиком поместиться в память с запасом. Если у тебя 16 ГБ оперативки — бери файл на 5–8 ГБ, а не на 15: остальное съест система, браузер и контекст диалога. Как только модель не влезла, начинается своп на диск, и ответы идут по слову в секунду.
Дальше по убыванию приоритета:
- Q4_K_M — дефолт. Модель на 7–8B в нём весит около 4.5–5 ГБ и работает почти как оригинал. Если сомневаешься — бери его.
- Q5_K_M — если памяти с запасом и хочется чуть точнее.
- Q8_0 — когда сравниваешь качество и место не жалко.
- Q3 и ниже — только когда иначе вообще не влезает. На маленьких моделях такое сжатие уже заметно ломает ответы.
И контринтуитивный момент: большая модель в грубом кванте обычно умнее маленькой в точном. 13B в Q4 чаще лучше, чем 7B в Q8, при похожем весе файла.
Ты уже пользуешься GGUF, даже если не качал его
Если ты запускал модель через Ollama или LM Studio — ты уже скачал GGUF, просто не видел его.
ollama run gemma3:4b идёт за тем же файлом, выбирает квант за тебя (обычно как раз Q4) и кладёт в свою папку. Разница между инструментами — в том, насколько подробно они дают тебе в это лезть: подробнее об этом в сравнении Ollama и LM Studio, а сам процесс с нуля — в гайде как запустить ИИ-модель локально.
Знание про суффиксы нужно ровно в тот момент, когда дефолт не подошёл: тормозит, не влезло, или наоборот — памяти много, а качество слабое.
GGUF и GGML — это одно и то же?
Нет, GGUF пришёл на смену GGML. Старый формат не умел хранить метаданные гибко: каждое новшество ломало совместимость, и файлы приходилось перекачивать. GGUF сделали расширяемым — новые поля можно добавлять, не ломая старые файлы. Если наткнулся на .bin с пометкой ggml — это архив прошлой эпохи, ищи GGUF.
Почему у свежей модели нет GGUF?
Потому что авторы выкладывают оригинал (обычно .safetensors), а GGUF делает сообщество — конвертирует и квантует скриптами из llama.cpp. Обычно это занимает от пары часов до пары дней. Если модель совсем новой архитектуры, ждать придётся дольше: сначала поддержку должны добавить в сам движок, иначе файл просто не запустится.
Курс «Профессия 2027: ИИ-архитектор»: шаг за шагом от основ компьютера до своего приложения и первых клиентов. 543 коротких урока на телефоне.
Читайте дальше

Ed25519 или RSA — какой SSH-ключ выбрать в 2026 году

Что такое sudo — и почему он спрашивает твой пароль, а не пароль админа

Что такое tar.gz — и почему архив tar бывает больше самих файлов

Что такое флаг в команде — и почему git commit -ma ломается, а -am нет

scp или rsync — и почему второй раз rsync отправил 141 байт вместо двух мегабайт
